你时间花在哪里,就表示你重视哪里。
一、概念
AOI算法
AOI(area of interested)算法
红包算法
红包算法(总和870,随机分成3份,每一份不大于300)
字符串匹配算法
LRU
一、概念
- LRU是Least Recently Used的缩写,即最近最少使用,常用于页面置换算法,是为虚拟页式存储管理服务的。
- 设计原则:如果一个数据在最近一段时间没有被访问到,那么在将来它被访问的可能性也很小。当限定的空间已存满数据时,应当把最久没有被访问到的数据淘汰。
二、实现
- 数组方式
- 用一个数组来存储数据,给每一个数据项标记一个访问时间戳;
- 每次插入新数据项的时候,先把数组中存在的数据项的时间戳自增,并将新数据项的时间戳置为0并插入到数组中;
- 每次访问数组中的数据项的时候,将被访问的数据项的时间戳置为0;
- 当数组空间已满时,将时间戳最大的数据项淘汰。
- 链表方式
- 用一个链表来存储数据;
- 每次新插入数据的时候将新数据插到链表的头部;
- 每次数据被访问到将数据移到链表头部;
- 当链表满的时候,就将链表尾部的数据丢弃。
三、常见缓存淘汰算法
- FIFO:first in first out,先进先出,即假定刚刚加入的数据总会被访问到;
- LRU:least recently used,最近最少使用,判断最近被使用的时间,假定未被使用的时间越久就不可能在被使用;
- LFU:least frequently used,数据使用次数最少的,优先被淘汰。
分布式一致性算法
一、核心概念
在分布式系统中,网络延迟、节点宕机、消息丢失等异常情况普遍存在,一致性算法的核心作用是保障多个独立节点的数据最终统一、状态同步,解决分布式场景下的「数据分歧」问题。根据一致性强度、同步机制、适用场景的不同,主流分为强一致性算法(Paxos、Raft、ZAB)和最终一致性算法(Gossip)两大类。
1.1 分布式一致性分类
强一致性:客户端任意时刻访问任意节点,获取的数据都是最新且一致的,写入操作成功后,所有节点立即同步数据,牺牲部分可用性换取数据绝对准确。
最终一致性:短暂时间内节点数据可能不一致,经过一段时间的异步同步后,所有节点数据最终达成统一,牺牲实时一致性换取高可用性、高扩展性。
1.2 四大算法基础定义
Paxos:经典的分布式强一致性共识算法,是所有强一致性算法的理论基础,基于二阶段提交优化,解决分布式节点容错共识问题,理论严谨但实现复杂。
Raft:Paxos的简化工程实现方案,将复杂的共识逻辑拆解为选举、日志复制、安全性三大模块,逻辑清晰、易于落地,是目前工业界主流的强一致性算法。
ZAB:ZooKeeper专用的原子广播协议,基于Paxos优化改造,适配ZooKeeper的协调场景,侧重消息有序性、原子性,专为分布式协调服务设计。
Gossip:又称谣言协议,去中心化的最终一致性同步算法,通过节点之间随机两两通信同步数据,无主节点、极致轻量,适配大规模集群。
二、四大算法全方位对比
2.1 核心特性对比
| 对比维度 | Paxos | Raft | ZAB | Gossip |
|---|---|---|---|---|
| 一致性级别 | 强一致性 | 强一致性 | 强一致性(有序一致性) | 最终一致性 |
| 节点架构 | 去中心化、无主节点 | 中心化、领导者-追随者架构 | 中心化、领导者-追随者架构 | 完全去中心化 |
| 容错能力 | 容忍半数以下节点宕机 | 容忍半数以下节点宕机 | 容忍半数以下节点宕机 | 无严格容错上限,集群规模越大越稳定 |
| 实现难度 | 极高,逻辑晦涩、分支复杂,工程落地成本大 | 低,逻辑模块化、规则清晰,易实现、易维护 | 中等,适配 ZK 场景,针对性优化但通用性弱 | 极低,逻辑简单,无需复杂协商机制 |
| 同步方式 | 二阶段协商(准备+提交) | 领导者统一日志复制同步 | 原子广播,分阶段消息推送同步 | 节点随机两两异步同步 |
| 数据有序性 | 不保证全局有序 | 保证全局日志有序 | 严格保证事务有序性(核心特性) | 不保证有序,同步顺序随机 |
| 性能开销 | 高,两轮协商网络开销大 | 中等,日志复制高效,开销可控 | 中等,针对协调场景优化,开销稳定 | 极低,异步轻量同步,无协商开销 |
2.2 各算法核心原理与优缺点
2.2.1 Paxos 算法
Paxos 是分布式一致性的基石算法,核心角色分为提案者、接受者、学习者,通过准备阶段和提交阶段的两轮协商,确保集群内多数节点认可同一提案,最终达成数据一致。
优点:理论完备、安全性极高、无主节点单点问题,容错性稳定,是分布式一致性的标准理论模型。
缺点:算法逻辑复杂,存在活锁问题(多个提案者竞争导致协商失败),没有日志有序机制,不适合直接落地工程项目。
2.2.2 Raft 算法
Raft为解决Paxos工程落地难题而生,将复杂的共识逻辑拆分为领导者选举、日志复制、安全性校验三大独立模块。集群中仅有一个领导者,所有写入请求经领导者处理后,同步给所有追随者,简化协商流程。
优点:逻辑清晰、易于理解和实现,解决了 Paxos 活锁问题,保证日志全局有序,性能稳定,适配绝大多数分布式存储、注册中心场景。
缺点:依赖领导者节点,存在主节点单点故障风险(可通过重新选举快速恢复),极端场景下性能略低于优化后的 Paxos。
2.2.3 ZAB 算法
ZAB(ZooKeeper Atomic Broadcast)是专为ZooKeeper设计的原子广播协议,基于 Paxos 改良,核心目标是实现分布式协调的有序一致性。算法分为崩溃恢复、消息广播两个阶段,严格保证所有事务按照全局唯一顺序执行。
优点:事务严格有序、原子性极强,适配分布式锁、配置管理、服务注册等协调场景,崩溃恢复速度快,稳定性高。
缺点:通用性极差,仅适配 ZooKeeper 架构,无法通用在其他分布式系统中,扩展性有限。
2.2.4 Gossip 算法
Gossip是去中心化的异步同步算法,无主节点、无选举机制。集群中每个节点周期性随机选择其他节点,两两交换本地数据,通过多轮随机传播,最终让全集群数据达成一致,模拟谣言传播机制。
优点:架构极简、扩展性极强,支持上万节点大规模集群,容错性极高(部分节点故障不影响整体同步),性能开销极低。
缺点:无法保证实时一致性,数据同步存在延迟,不适合对数据实时性、准确性要求高的场景,仅适用于最终一致性业务。
2.3 适用场景总结
Paxos:底层理论研究、核心金融级强一致性系统(自研底层共识模块),极少直接用于普通工程开发。
Raft:工业界主流方案,ETCD、Consul、Nacos 等中间件核心算法,适用于分布式配置中心、注册中心、分布式存储。
ZAB:专属 ZooKeeper,仅用于分布式协调服务(分布式锁、集群管理、事务协调)。
Gossip:大规模集群状态同步,如 Redis 集群、Cassandra、Elasticsearch 节点状态同步、服务发现、舆情同步等最终一致性场景。
三、参考
排序算法
一、十大排序算法
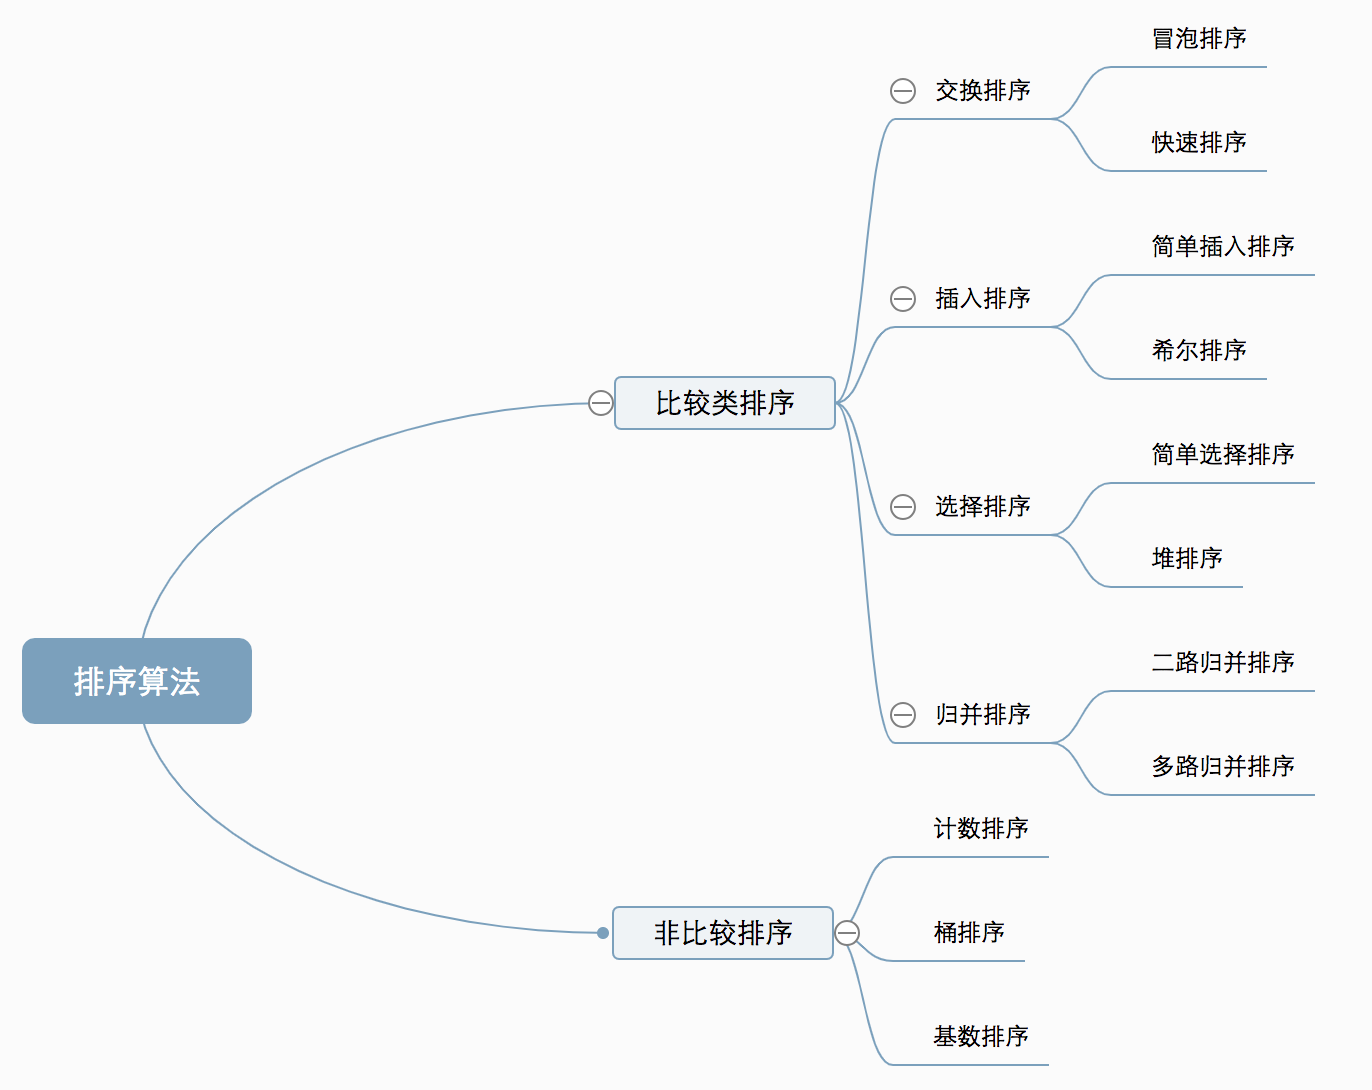
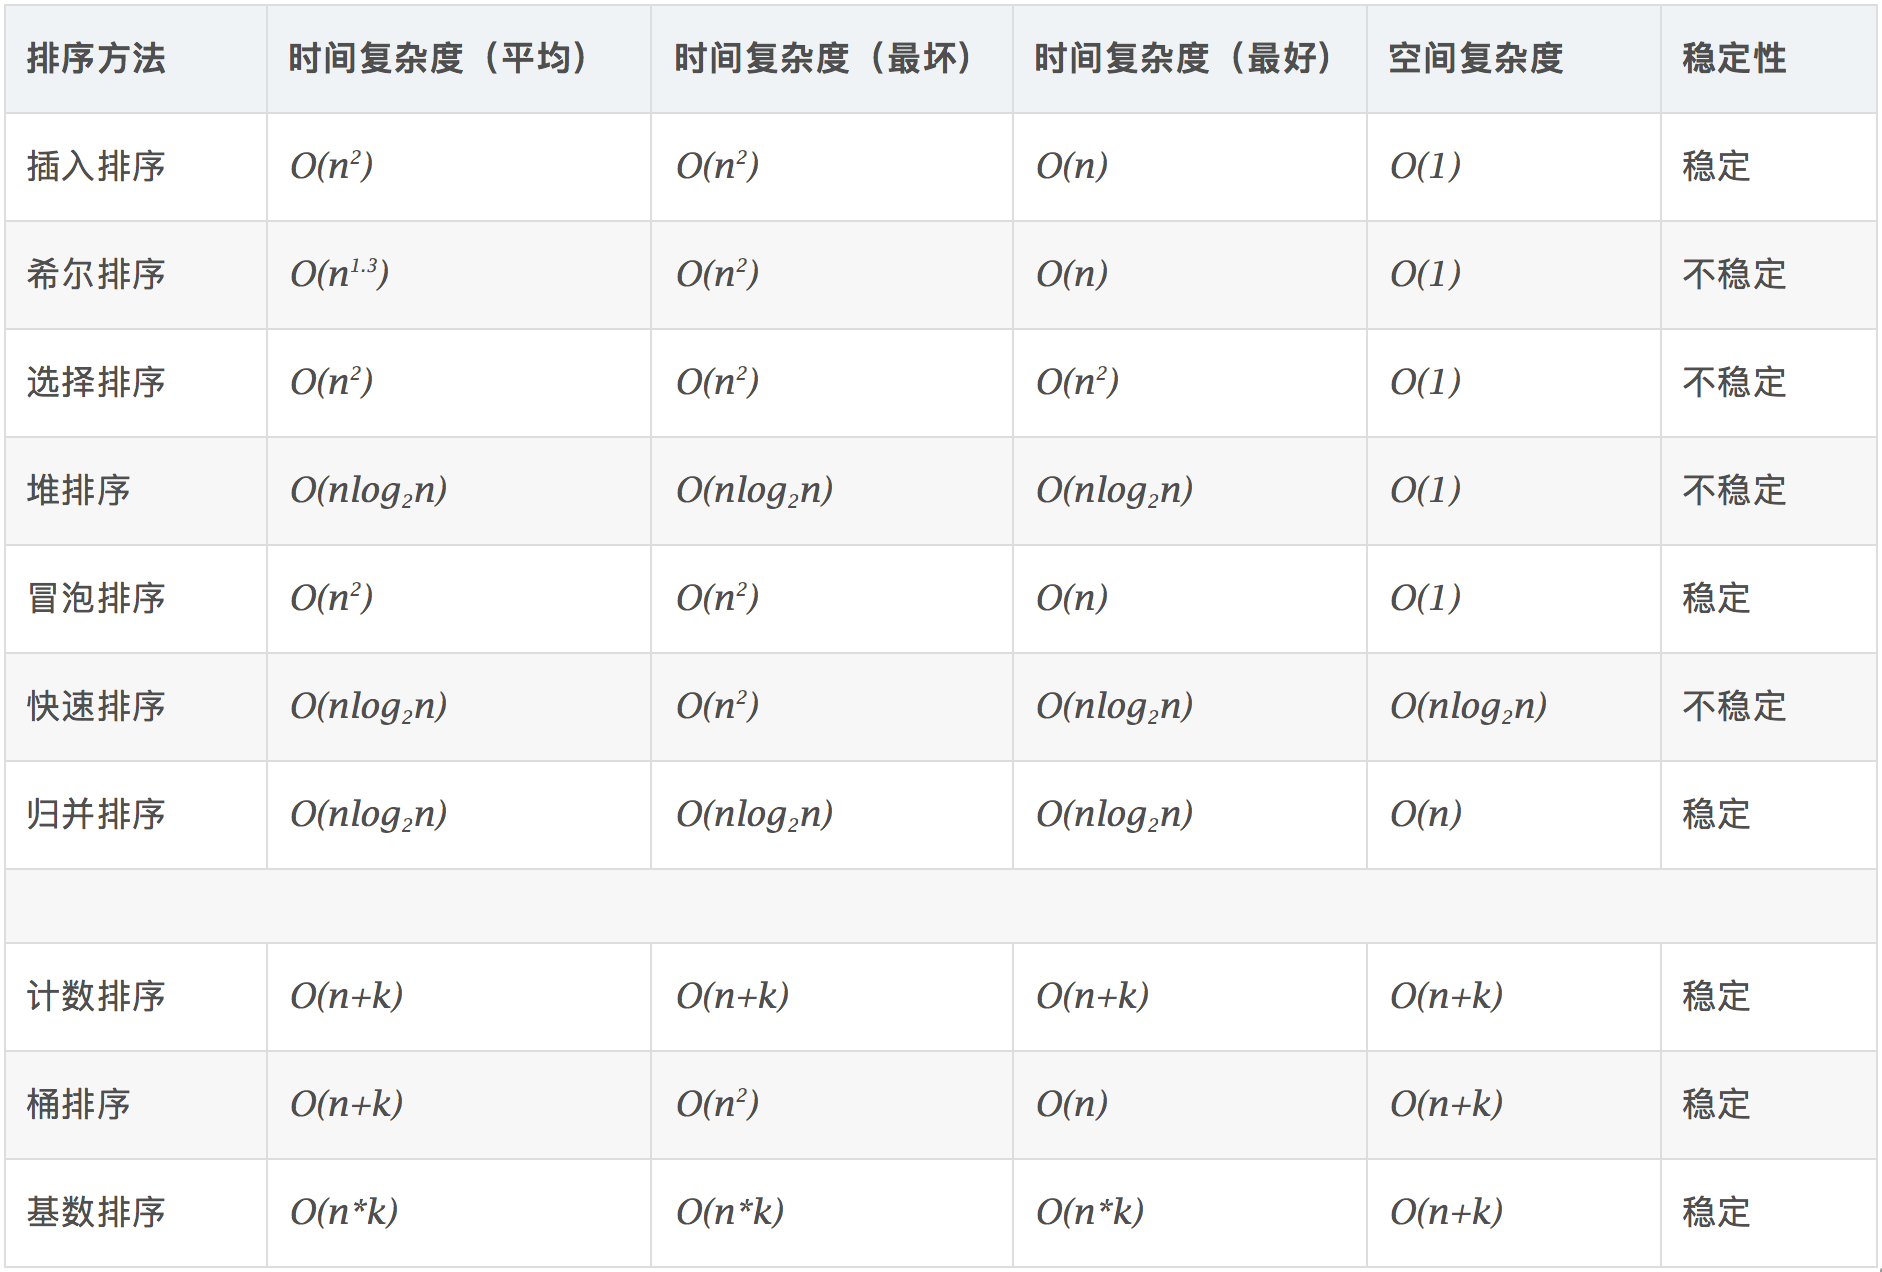
相关概念
- 稳定:如果a原本在b前面,而a=b,排序之后a仍然在b的前面。
- 不稳定:如果a原本在b的前面,而a=b,排序之后 a 可能会出现在 b 的后面。
- 时间复杂度:对排序数据的总的操作次数。反映当n变化时,操作次数呈现什么规律。
- 空间复杂度:是指算法在计算机内执行时所需存储空间的度量,它也是数据规模n的函数。
一、冒泡排序
- 概念
冒泡排序只会操作相邻的两个数据。每次冒泡操作都会对相邻的两个元素进行比较,看是否满足大小关系要求。如果不满足就让它俩互换。一次冒泡会让至少一个元素移动到它应该在的位置,重复n次,就完成了n个数据的排序工作。
- 实现
1 | function bubbleSort($data) |
二、快速排序
- 概念
从数列中挑出一个元素,称为基准(pivot),依次取所有元素和基准对比,所有比基准小的元素摆放在基准前面,所有比基准值大的元素摆在基准后面。然后基于递归(recursively)算法把小于基准值元素的子数列和大于基准值元素的子数列排序,最终得到结果。
- 实现
1 | function quickSort($data) |
三、插入排序
概念
将数组中的数据分为两个区间,已排序区间和未排序区间。初始已排序区间只有一个元素,就是数组的第一个元素。插入算法的核心思想是依次取未排序区间中的元素,在已排序区间中找到合适的插入位置将其插入,并保证已排序区间数据一直有序。重复这个过程,直到未排序区间中元素为空,算法结束。- 插入排序是一种基于比较的排序算法。
实现
1 | function insertionSort($data) |
四、选择排序
概念
选择排序算法的实现思路有点类似插入排序,也分已排序区间和未排序区间。但是选择排序每次会从未排序区间中找到最小的元素,将其放到已排序区间的末
尾(升序时)。实现
1 | function selectionSort($data) |
五、希尔排序
- 概念
希尔排序(Shell’s Sort)是插入排序的一种又称“缩小增量排序”(Diminishing Increment Sort),是直接插入排序算法的一种更高效的改进版本。希尔排序是非稳定排序算法。该方法因D.L.Shell于1959年提出而得名。 - 实现
六、归并排序
给定一个待排序数组,先把数组从中间分成前后两部分,然后对前后两部分分别排序,再将排好序的两部分合并在一起,这样整个数组就都有序了。
归并排序使用的就是分治思想。
- 分治算法一般都是用递归来实现的
- 分治是一种解决问题的处理思想,递归是一种编程技巧,两者并不冲突
实现
1 | function mergeSort($data) |
七、基数排序
- 算法原理(以排序10万个手机号为例来说明)
- 比较两个手机号码a,b的大小,如果在前面几位中a已经比b大了,那后面几位就不用看了
- 借助稳定排序算法的思想,可以先按照最后一位来排序手机号码,然后再按照倒数第二位来重新排序,以此类推,最后按照第一个位重新排序
- 经过11次排序后,手机号码就变为有序的了
- 每次排序有序数据范围较小,可以使用桶排序或计数排序来完成
- 使用条件
- 要求数据可以分割独立的“位”来比较
- 位之间有递进关系,如果a数据的高位比b数据大,那么剩下的地位就不用比较了
- 每一位的数据范围不能太大,要可以用线性排序,否则基数排序的时间复杂度无法做到O(n)
八、计数排序
- 算法原理
- 计数其实就是桶排序的一种特殊情况
- 当要排序的n个数据所处范围并不大时,比如最大值为k,则分成k个桶
- 每个桶内的数据值都是相同的,就省掉了桶内排序的时间
九、桶排序
- 算法原理:
- 将要排序的数据分到几个有序的桶里,每个桶里的数据再单独进行快速排序
- 桶内排完序之后,再把每个桶里的数据按照顺序依次取出,组成的序列就是有序的了
- 使用条件
- 要排序的数据需要很容易就能划分成m个桶,并且桶与桶之间有着天然的大小顺序
- 数据在各个桶之间分布是均匀的。
- 适用场景
- 桶排序比较适合用在外部排序中
- 外部排序就是数据存储在外部磁盘且数据量大,但内存有限无法将整个数据全部加载到内存中。
十、堆排序
- 堆排序(英语:Heapsort)是指利用堆这种数据结构所设计的一种排序算法。堆是一个近似完全二叉树的结构,并同时满足堆积的性质:即子节点的键值或索引总是小于(或者大于)它的父节点。
十一、优先队列排序算法
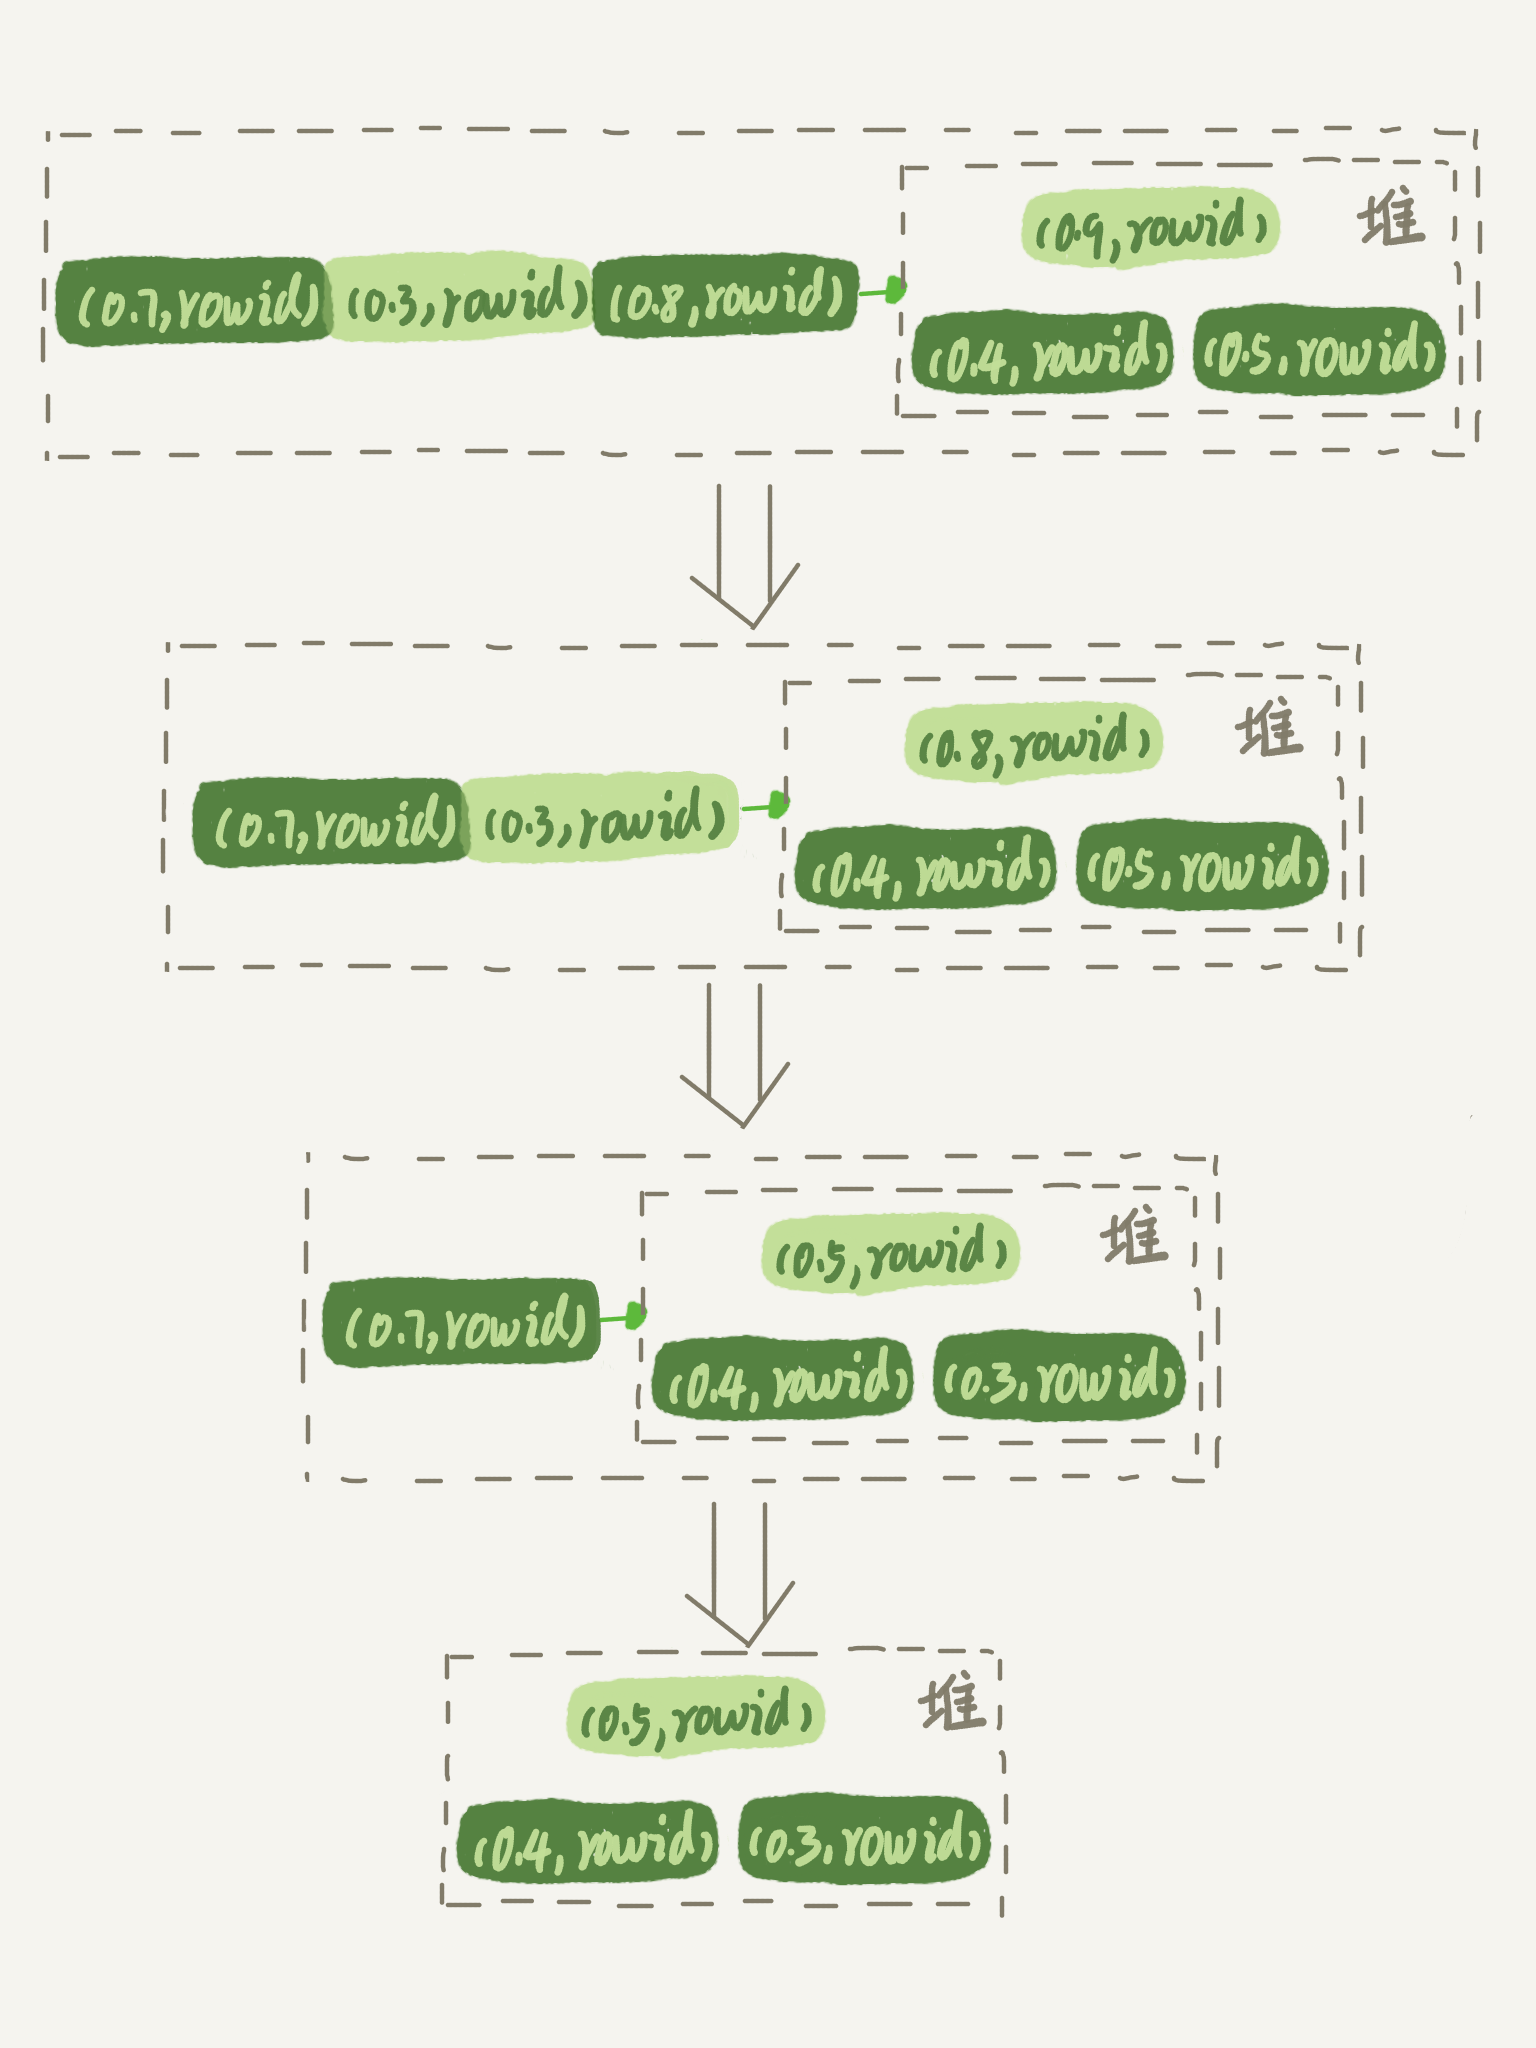
- 问题:从10000个记录行中取随机取三个最小值
- 过程如下
- 对于这 10000 个准备排序的 (R,rowid),先取前三行,构造成一个堆;
- 取下一个行 (R’,rowid’),跟当前堆里面最大的 R 比较,如果 R’小于 R,把这个 (R,rowid) 从堆中去掉,换成 (R’,rowid’);
- 重复第 2 步,直到第 10000 个 (R’,rowid’) 完成比较。
查找算法
一、七大查找算法
- 顺序查找
- 二分查找
- 插值查找
- 斐波那契查找
- 树表查找
- 分块查找
- 哈希查找
二、实战
单链表取中间节点
单向链表(单链表)是链表的一种,是由一系列的存储数据元素的单元(通常称为结点node)通过指针串接起来形成的,每个单元至少有两个域,一个域用于数据元素的存储,另一个域是指向其他单元的指针。
特性
- head指针指向第一个结点(表头结点),最后一个节点的next指针为null
- 在已知待操作结点位置的情况下,插入和删除的时间复杂度是O(1)
实现
- 方案一:遍历整个单链表,得到链表的长度length,length/2即为单链表的中间结点。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
function getMiddleNode($head) {
if ($head == null || $head->next == null){
return $head;
}
$prev = $head;
$size = 0;
while($prev) {
$size++;
$prev = $prev->next;
}
$position = (int)($size/2);
while($position--) {
$head=$head->next;
}
return $head;
}- 方案二:设置两个指针
i和j,i一次走一步,j一次走两步,当j到达链表尾的时候,i所指向的结点就是单链表的中间结点。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
function getMiddleNode($head){
if ($head == null || $head->next == null){
return $head;
}
$p1 = $head;
$p2 = $head;
while($p2->next != null && $p2->next->next) {
$p2 = $p2->next->next
$p1 = $p1->next
}
return $p1;
}
垃圾回收算法
一、概念
在计算机科学中,垃圾回收(Garbage Collection,缩写为GC)是指一种自动的存储器管理机制,当某个程序占用的一部分内存空间不再被这个程序访问时,这个程序会借助垃圾回收算法向操作系统归还这部分内存空间。垃圾回收器可以减轻程序员的负担,也减少程序中的错误。垃圾回收最早起源于LISP语言,当前许多语言如Smalltalk、Java、PHP、Go、C#等都支持垃圾回收器。
二、分类
引用计数法(最早也是最简单的垃圾回收实现方法,1960年由
George E. Collins提出)- 原理:为对象附加一个计数器,当有其他对象引用这个对象时计数器加一,反之引用解除时减一。这种算法会定期检查尚未被回收的对象的计数器,为零的话则回收其所占物理空间,因为此时的对象已经无法访问。
- 优点:
- 实时性较高,无需等到内存不够的时候才开始回收,运行时根据对象的计数器是否为0就可以直接回收。
- 在垃圾回收过程中应用无需挂起。如果申请内存时,内存不足则立刻报
out of memory错误。 - 区域性(回收过程影响范围),更新对象的计数器时只是影响到该对象,不会扫描全部对象。
- 缺点:
标记-清除算法
- 原理:暂停整个程序的全部运行线程,让回收线程以单线程进行扫描标记,将垃圾回收分为2个阶段————标记和清除。标记阶段从根节点开始标记引用的对象;清除阶段则是直接清理未被标记引用的对象,回收完成后恢复运行线程。
- 优点:
- 解决了引用计数算法中的循环引用的问题
- 缺点:
- 效率低,标记和清除两个动作都需要遍历所有的对象,并且在GC时,需要停止应用程序,对于交互性要求比较高的应用而言这个体验是非常差的。
- 碎片化严重,从而使大容量对象不容易获得连续的内存空间,造成空间浪费。
标记-压缩算法(优化了的标记——清除算法),也称为标记-整理算法
- 原理:标记阶段从根节点开始,对对象的引用进行标记;清理阶段并不是简单的清理未标记的对象,而是将存活的对象压缩到内存的一端,然后清理边界以外的垃圾,从而解决了碎片化的问题。
- 优点:
- 解决了标记清除算法的碎片化的问题。
- 缺点:
- 标记压缩算法多了一步————对象移动内存位置,其效率也有一定的影响。
标记-复制算法
- 原理:将所拥有的内存空间分成两个部分。程序运行所需的存储对象先存储在其中一个分区(定义为“分区0”)。回收过程仍然是暂停整个程序的全部运行线程,进行标记后将保留的存储对象搬运汇集到另一个分区(定义为“分区1”)完成回收,程序在本次回收后将接下来产生的存储对象会存储到“分区1”。在下一次回收时,两个分区的角色对调。(简单理解:将原有的内存空间一分为二,每次只用其中的一块,在垃圾回收时,将正在使用的对象复制到另一个内存空间中,然后将该内存空间清空,交换两个内存的角色,完成垃圾的回收)
- 优点:
- 如果内存中的垃圾对象较多,需要复制的对象就较少,这种情况下适合使用该方式并且效率比较高
- 缺点:
- 同优点相反
增量回收器算法(增量GC名称的由来跟全量GC相对,就是每次只处理一小部分的对象)
- 原理:将所有的内存空间分成若干分区,程序运行所需的存储对象会分布在这些分区中,每次只对其中一个分区进行回收操作,从而避免暂停所有正在运行的线程来进行回收,允许部分线程在不影响回收行为下保持运行,并且降低回收时间,增加程序响应速度。
- 优点:
- 不会造成
stop the world
- 不会造成
- 缺点:
- 实现过程复杂
分代算法
- 原理:由于复制算法对于存活时间长、大容量的储存对象需要耗费更多的移动时间,和存在储存对象的存活时间的差异。需要程序将所拥有的内存空间分成若干分区,并标记为年轻代空间和年老代空间。程序运行所需的存储对象会先存放在年轻代分区,年轻代分区会较为频密进行较为激进垃圾回收行为,每次回收完成幸存的存储对象内的寿命计数器加一。当年轻代分区存储对象的寿命计数器达到一定阈值或存储对象的占用空间超过一定阈值时,则被移动到年老代空间,年老代空间会较少运行垃圾回收行为。一般情况下,还有永久代的空间,用于涉及程序整个运行生命周期的对象存储,例如运行代码、数据常量等,该空间通常不进行垃圾回收的操作。通过分代,存活在局限域、小容量、寿命短的存储对象会被快速回收;存活在全局域、大容量、寿命长的存储对象就较少被回收行为处理干扰。
如何判断一个对象是否应该回收
- 引用计数,该对象每被一个地方引用,计数器就加+1,引用失效时,计数器-1,计数器为0时的对象就不能再被使用,很难解决循环引用的问题。
- 可达性分析法,通过gc roots作为起点,从这些节点开始向下搜索,当一个对象到gc roots没有任何引用链十则代表这个对象就是不可用的。
什么可以作为GC ROOT呢?
- 类静态属性中引用的对象(方法区)
- 常量引用的的对象(方法区)
- 虚拟机栈中引用的对象(栈帧中的本地变量表)
- jni引用的对象(本地方法栈)
- 除了垃圾回收,还有哪些工作会造成cpu负载过高,100%负载,并给出排查过程
三、参考
全局唯一ID
一、概念
随着应用业务的复杂,用户量的增长,单机部署已经不能满足现有的需求了,随之而来的就是在数据库层分库、分表,以及分布式部署应用等。全局唯一ID,其实就是在分布式应用中唯一标识某条记录的ID。生成全局唯一ID有两个基本要求:全局唯一性、趋势有序性。
ID生成系统的需求
- 全局唯一性:不能出现重复的ID,最基本的要求。
- 趋势递增:MySQL InnoDB引擎使用的是聚集索引,由于多数RDBMS使用B-tree的数据结构来存储索引数据,在主键的选择上面我们应尽量使用有序的主键保证写入性能。
- 单调递增:保证下一个ID一定大于上一个ID。
- 信息安全:如果ID是连续递增的,恶意用户就可以很容易的窥见订单号的规则,从而猜出下一个订单号,如果是竞争对手,就可以直接知道我们一天的订单量。所以在某些场景下,需要ID无规则。
二、常见算法
uuid
- 生成足够简单,本地生成无网络消耗,具有唯一性
- 无序的字符串,不具备趋势自增特性
- 没有具体的业务含义
数据库自增id
- 实现简单,ID单调自增,数值类型查询速度快
- DB单点存在宕机风险,无法扛住高并发场景
数据库多主模式
- 分别设置起始值和自增步长
- 可以解决DB单点问题
- 不利于后续扩容,高并发下单个数据库自身压力大
号段模式
- 从数据库批量的获取自增ID如1~1000并缓存在本地,减少数据库请求次数
1
2
3
4
5
6
7
8
9
10
11
12
13
14
CREATE TABLE id_generator (
id int(10) NOT NULL,
max_id bigint(20) NOT NULL COMMENT '当前最大id',
step int(20) NOT NULL COMMENT '号段的布长',
biz_type int(20) NOT NULL COMMENT '业务类型',
version int(20) NOT NULL COMMENT '版本号',
PRIMARY KEY (`id`)
)
biz_type:不同业务类型
max_id:当前最大的可用id
step:号段的长度
version:乐观锁
update id_generator set max_id = #{max_id+step}, version = version + 1 where version = # {version} and biz_type = XXXRedis
- incr
Mongo
1 | function getUniqId() { |
- 雪花算法
- Snowflake ID组成结构:
正数位(1比特)+时间戳(41比特)+workId(10比特)+自增值(12比特),总共64比特组成的一个Long类型ID。
- Snowflake ID组成结构:
- 滴滴TinyId
- 百度UidGenerator
- 美团Leaf